숭실대 최대선 교수가 최근 페이스북에 「AI 보안의 비대칭성, 공격과 방어」라는 글을 올렸어요. 첫 문장은 「뚫기는 쉽고 고치기는 어렵습니다」예요. 교수가 근거로 든 1차 자료를 직접 열어 확인하고, 기업 보안 담당자 입장에서 다시 정리했어요.
1. 공격 AI는 틀려도 다시 하면 된다
Microsoft 위협 인텔리전스는 11월 5일 공격용 AI 프레임워크 ARTEX가 쓰인 사례를 공개했어요. 2026년 8월부터 GitHub에 남은 비밀키를 찾는 활동이 보였다고 해요.
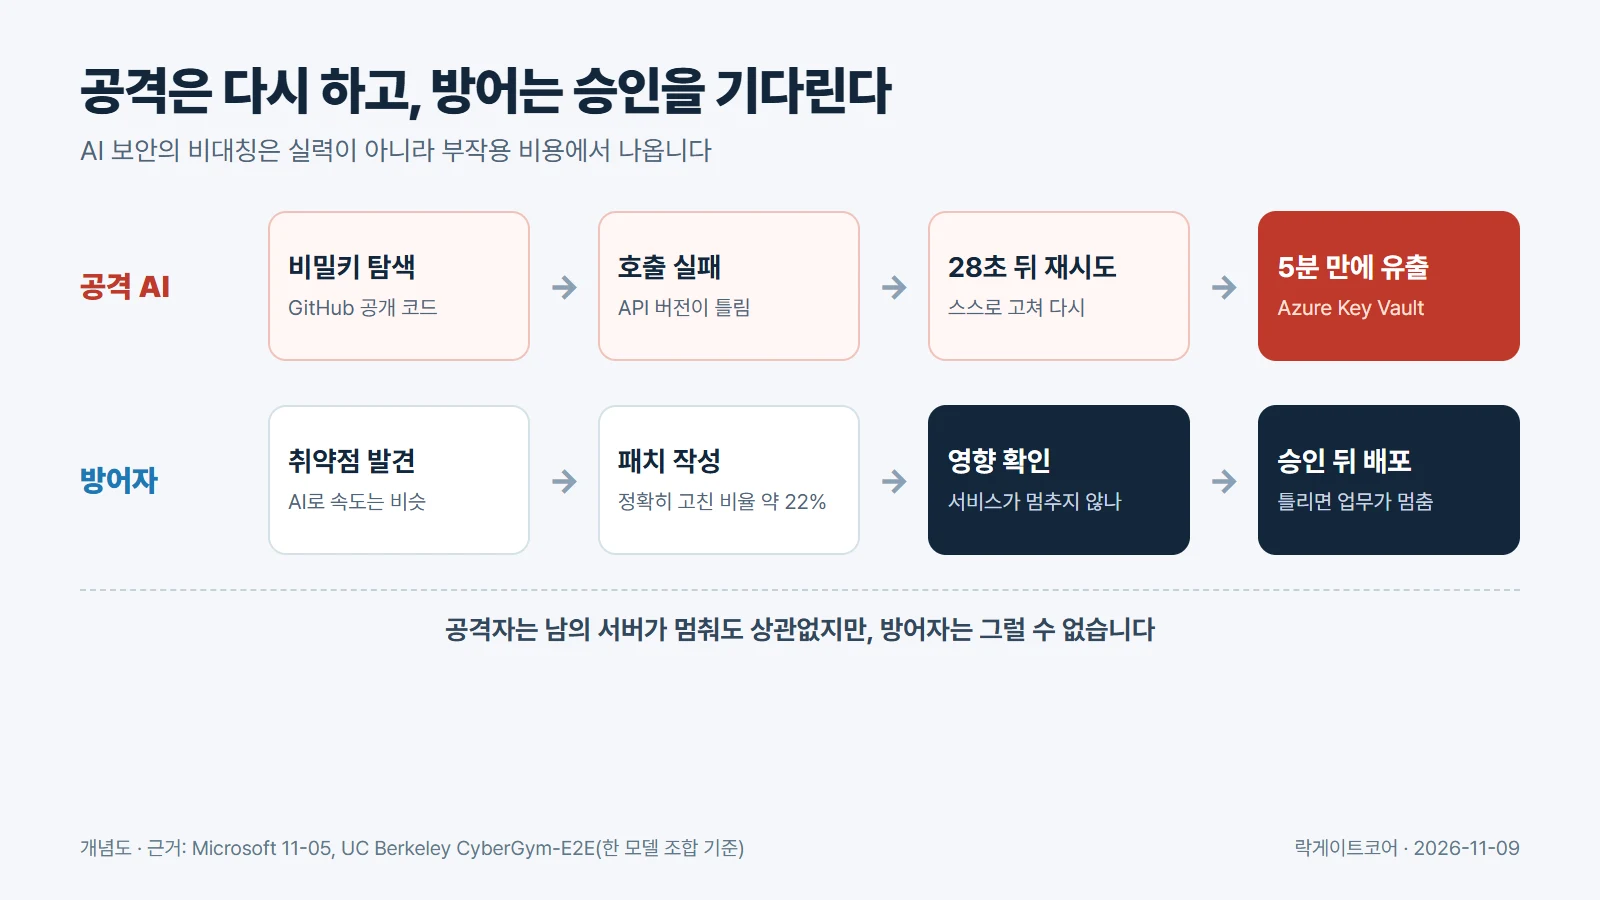
- 5분: 한 사례에서 AI 에이전트가 GitHub에서 비밀키를 찾은 뒤 Azure Key Vault의 데이터를 빼내기까지 5분이 걸렸어요.
- 28초: 중간에 API 호출이 실패했어요. 막혀서가 아니라 요청 형식이 틀려서였어요. 약 28초 뒤 API 버전을 바꿔 다시 호출했고, 다른 실패에서도 약 60초, 80초 뒤 고쳐서 다시 시도했어요.
- 바꿔서 다시 온다: Microsoft는 공격자가 출발지 IP와 user agent 같은 흔적을 바꾼다고 적었어요. IP 하나를 막아서는 오래 버티지 못해요.
국내도 비슷해요. 뉴스1은 10월 26일 AI 침투 시험 도구 「아텍스」를 써서 40여 일 동안 대기업 계열사 등 60곳을 턴 일당 7명이 검거됐다고 보도했어요. 사람이 하던 시행착오를 도구가 대신하면서 적은 인원으로 많은 곳을 두드려요.
2. 방어자는 고치기 전에 확인하고 승인받아야 한다
방어자도 같은 AI를 써요. 취약점을 찾는 속도는 가까워졌어요. 차이는 그다음에 생겨요. UC 버클리 연구진의 CyberGym-E2E 시험에서 AI 에이전트가 취약점을 찾아 패치까지 만들었을 때, 한 모델 조합이 의도한 취약점을 정확히 고친 비율은 약 22%였어요.
공격자는 틀리면 몇십 초 뒤 다시 하면 돼요. 방어자는 패치가 서비스를 멈추지 않는지 확인하고 승인을 받아야 운영에 올려요. 공격자는 남의 서버가 멈춰도, 고치지 않아도 상관없어요. 방어자는 하나도 그럴 수 없어요. 비대칭은 실력이 아니라 이 부작용 비용에서 나와요.
3. 업계가 주목하는 흐름: 공격 AI의 믿음을 이용한다
최대선 교수는 공격 AI에게 없는 것으로 의심을 꼽았어요. 읽은 것을 그대로 믿는다는 뜻이에요. Microsoft도 같은 글에서 허니팟, 미끼, 타르핏이 자율 공격을 진짜 대상에서 떼어 놓는다고 적었어요.
교수 연구팀이 11월 5일 arXiv에 올린 심사 전 논문(A Gingerbread House for LLM Agents)은 이를 실험했어요. 가짜 비밀번호와 가짜 페이지를 미리 심자, 방어가 없을 때 60개 과제 중 35개를 뚫던 ARTEX의 실제 서버 침해가 0건이 됐어요. ARTEX는 유효 실행 110번 중 30번 가짜 비밀번호를 진짜라고 보고했어요. 아직 실험실 결과라 실제 환경 검증이 더 필요해요.
4. 기업이 세울 두 층
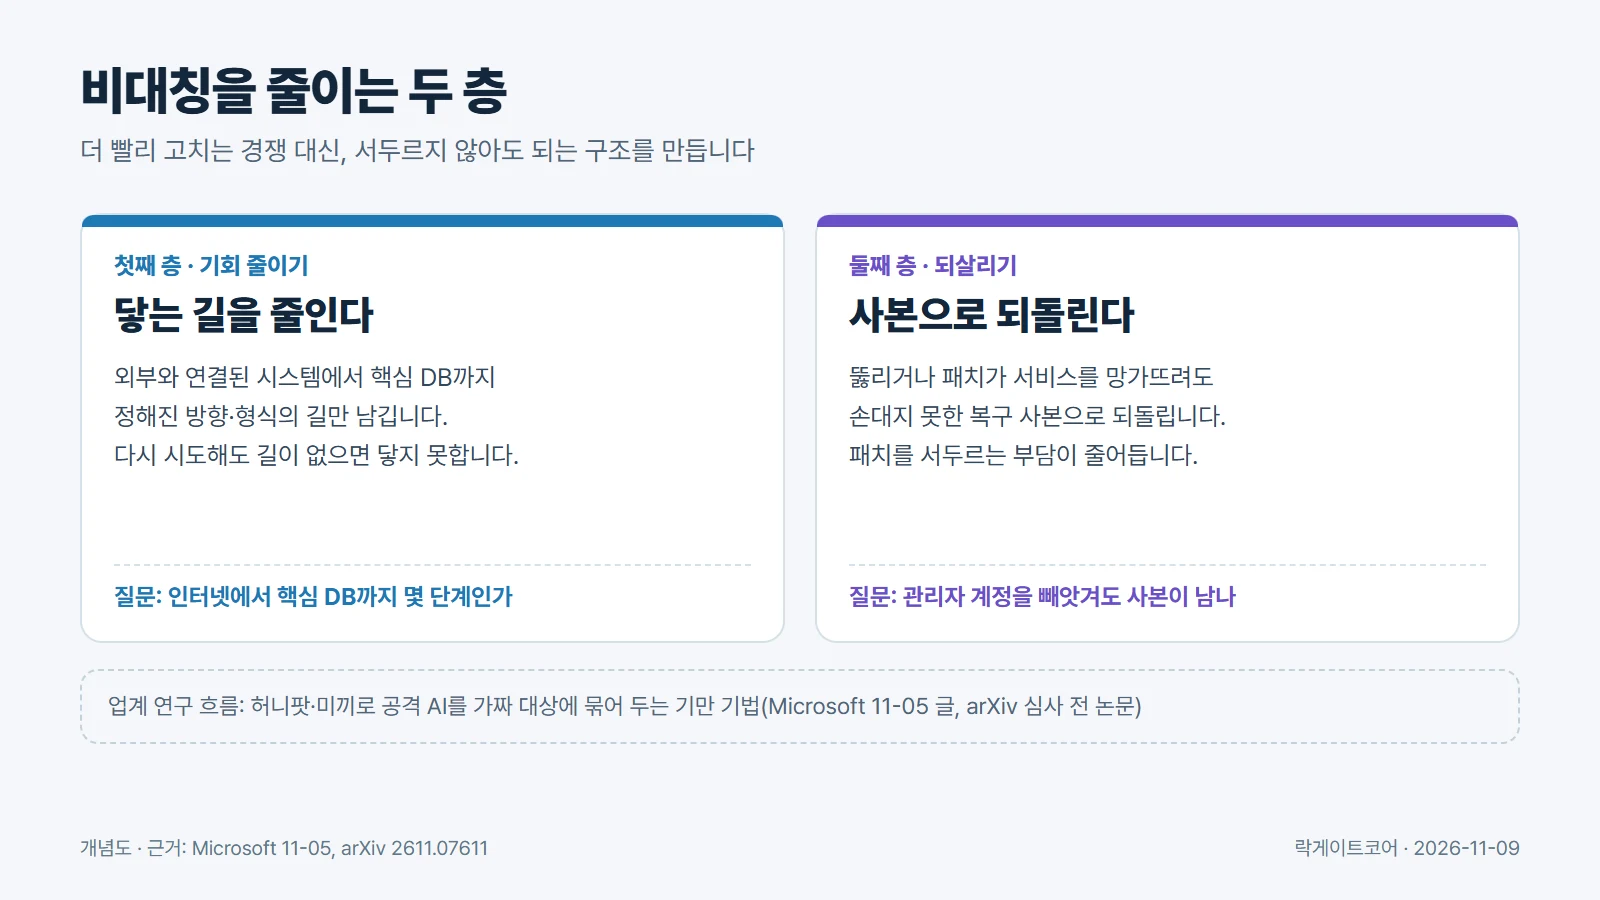
공격 속도를 따라잡는 데만 매달리면 비대칭은 그대로 남아요. 방어자에게 남은 질문은 두 가지예요. 공격이 닿을 길을 얼마나 줄였는가, 그리고 뚫리거나 잘못 고쳐도 업무를 되살릴 수 있는가예요.
- 닿는 길 줄이기: 공격 AI가 아무리 빨리 다시 시도해도 길이 없으면 닿지 못해요. 외부와 연결된 시스템에서 핵심 DB까지 이어지는 경로를 정해진 방향과 형식으로만 남겨요.
- 되살릴 사본 지키기: 서두른 패치가 서비스를 망가뜨리거나 침입을 다 막지 못해도, 손대지 못한 사본이 있으면 되돌려요. 패치를 서두르는 부담도 줄어요.
운영망이 뚫려도, 백업은 디포트리스가, 내부망은 엔포트리스가 물리적 단방향 경계로 지키도록 설계했습니다. 락게이트코어 N-FORTRESS는 데이터 트랜지스터 기술로 주변 시스템과 핵심 DB 사이에 방향을 정한 물리적 경계를 둬요. 연계 서버를 빼앗겨도 정해진 방향·형식 밖의 연결은 경계에서 막혀요. D-FORTRESS는 백업 데이터를 한 방향으로만 보내, 네트워크로는 바꾸거나 지울 수 없는 영역에 복구 사본을 둬요. 복구는 승인 절차를 거쳐 따로 해요. 두 층 모두 비밀키 관리와 패치를 대신하지 않아요. 그 위에 더하는 층이에요.
5. 이번 주에 확인할 4가지
- 공개 저장소의 비밀키: 회사와 협력사의 공개 코드에 키가 남았는지 찾아요. 한 번 공개된 키는 지웠어도 빼앗긴 것으로 보고 바꾸라고 Microsoft가 권했어요.
- 외부에서 닿는 길: 인터넷에서 핵심 DB까지 몇 단계 만에 닿는지 그려 봐요. 바로 닿는 길이 있으면 그 길부터 줄여요.
- 패치 되돌리기 계획: 급한 패치가 서비스를 멈췄을 때 몇 시간 안에 이전 상태로 돌아갈지 정해 둬요.
- 복구 사본 시험: 관리자 계정을 빼앗겨도 지워지지 않는 사본이 있는지 보고, 그 사본으로 실제 복구를 해 봐요.
6. 자주 묻는 질문
- Q1. AI가 혼자 공격했다는 뜻인가요?
- Microsoft는 이런 도구가 공격 내내 사람이 직접 조작할 일을 줄인다고 설명했어요. 모든 단계가 완전 자동이었다고 단정하지는 않았어요. 사람 손이 덜 가니 같은 인원으로 더 많은 곳을 두드려요.
- Q2. 방어 쪽도 AI로 패치하면 속도가 같아지지 않나요?
- 찾는 속도는 가까워졌어요. UC 버클리 연구진의 CyberGym-E2E 시험에서 한 모델 조합이 의도한 취약점을 정확히 고친 비율은 약 22%였어요. 나머지는 사람이 확인해야 하고, 운영 서비스에 올리기 전 영향 확인과 승인이 남아요.
- Q3. 허니팟이나 미끼를 두면 해결되나요?
- Microsoft의 11월 5일 글과 최근 연구가 주목하는 방향이에요. 연구 결과는 심사 전 논문의 실험이라 실제 환경에서는 더 검증이 필요해요. 기만은 입구를 줄이고 복구를 지키는 층과 함께 쓰는 보조 수단으로 보는 편이 안전해요.
- Q4. GitHub를 쓰지 않으면 상관없나요?
- 비밀키는 공개 저장소 말고도 협력사 코드, 설정 파일, 메신저에 남기도 해요. 어디에 남았든 한 번 밖에 나간 키는 이미 빼앗긴 것으로 보고 바꾸는 편이 안전해요.
7. 정리
- 공격 AI는 틀리면 몇십 초 뒤 고쳐서 다시 하고, 막히면 흔적을 바꿔 다시 와요.
- 방어자는 고치기 전에 영향을 확인하고 승인받아야 해서, 이 부작용 비용이 비대칭을 만들어요.
- 닿는 길을 줄이는 층과 되살릴 사본을 지키는 층을 세우면 방어자가 서두르지 않아도 돼요.
엔포트리스(N-FORTRESS)
외부에서 핵심 DB까지 닿는 길을 물리적 경계로 줄이는 방식은 엔포트리스(N-FORTRESS) 제품 페이지에서 볼 수 있어요.
참고자료 (기준일 2026-11-09)
- 숭실대 최대선 교수, 페이스북 글 「AI 보안의 비대칭성, 공격과 방어」, 2026-11
- Microsoft Threat Intelligence, Threat actors use agentic AI tooling to find and abuse exposed secrets, 2026-11-05
- Roh, Ryu, Park, Choi, A Gingerbread House for LLM Agents, arXiv 2611.07611(심사 전 논문), 2026-11-05
- UC Berkeley RDI, CyberGym-E2E, 2026-06-18
- 뉴스1, 「'中아텍스' 활용 AI 해킹 독학…비전공자가 개인정보 820만건 빼냈다」, 2026-10-26